那条只用了三分钟的CDN预热命令,让线上服务整整瘫痪了16个小时。
背景复盘
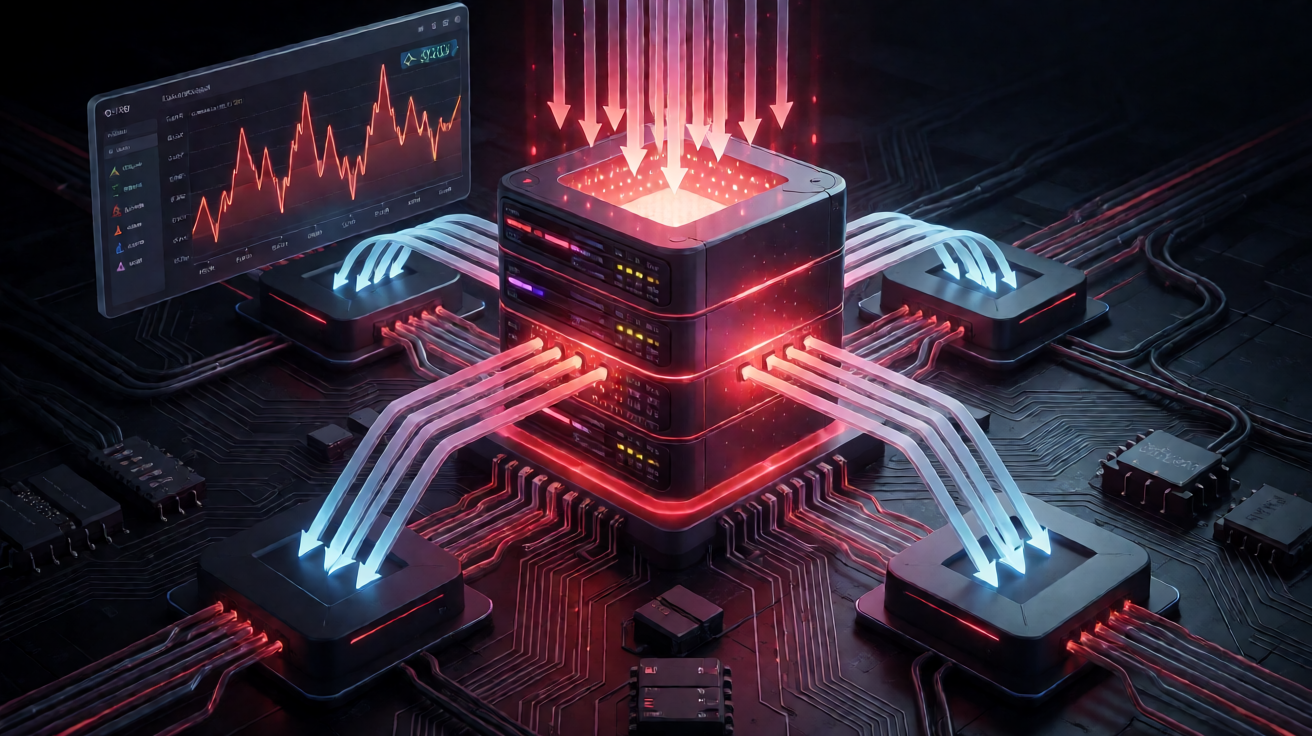
昨晚22点左右,运维团队执行了一条看似常规的CDN预热脚本,目的是让当天即将上线的大促资源提前分发到边缘节点,避免活动高峰时回源。脚本逻辑极其简单:遍历资源清单,对每个URL直接调用CDN预热接口,并发数设置为一百五十。命令跑完的前十秒,告警平台开始疯狂推送——源站带宽曲线以近乎垂直的角度上冲,CPU使用率瞬间打满,核心API响应延迟从正常的几十毫秒飙升到数秒,CDN命中率曲线反而跌破警戒线。不到一分钟,WAF/CC防护策略因为回源流量异常而自动触发限速甚至封禁逻辑,整个站点直接对外表现为不可用,用户侧看到的是持续超时的空白页面。这就是事故现场:一条预热命令,把本该加速分发的边缘网络,变成了一个把流量集中砸回源站的「请求泵」。
根因分析
为什么预热会变成灾难?预热机制的本质,是源站向边缘节点批量推送内容,或在边缘节点未命中时回源拉取。当脚本以高并发同时发起大量预热请求时,这些请求并不分布在用户真实的访问地域上,而是从同一批节点、同一时刻涌向源站。一旦预热内容尚未真正命中缓存、或CDN侧的预热任务回源策略被配置为「全量回源」,所有请求会直接穿透到源站。此时源站带宽和计算资源瞬间被打满,服务响应延迟飙升,形成典型的「大流量直接冲击源站」场景。更隐蔽的是,WAF和CC防护默认会把短时间内异常集中的来源流量判定为攻击或刷量行为,从而触发限速、封禁等动作——防护机制反而成了雪上加霜的一环。多条线上事故复盘都指向同一个结论:预热不及时或预热方式不当,会让请求直接穿透CDN,瞬间压垮源站。
技术细节
预热之所以是「加速分发」而不是「源站过载」,靠的其实是异步、错峰、分片。健康的预热流程应当是:边缘节点按地域分批向源站拉取,每次拉取之间留有间隔,单个节点的回源速率被严格约束,源站看到的回源流量是平滑可预测的。而我们的脚本采用的是同步并发预热——在一百五十个并发下,所有预热任务几乎在同一毫秒发起,源站面对的是一张密集的「回源请求风暴」。边缘CDN的缓存尚未建立,命中率自然极低,全部请求都要回源。底层逻辑就在这里:同步并发把「分布式的边缘取数」坍缩成了「集中式的源站取数」,分发的红利被完全抵消,反而放大为源站的灾难。监控上会清晰看到,预热发起的瞬间QPS激增,而缓存命中率不升反降,回源带宽曲线陡峭抬升。
数据佐证
事故后拉取监控数据复盘。预热命令发起的十秒内,核心接口QPS从基线的每分钟数千次跳到峰值,同时5xx错误率与回源带宽曲线几乎同步飙升:5xx错误率从正常的接近零一路攀升,源站出口带宽被打满,响应延迟突破秒级。两条曲线的「齐步走」就是回源风暴的直接证据——流量不是被边缘缓存承接,而是全部落回源站并被防护策略压制。正是基于这些可观测数据,团队才最终定位到问题出在预热脚本的并发模型,而非CDN本身故障或上游网络抖动。
紧急修复
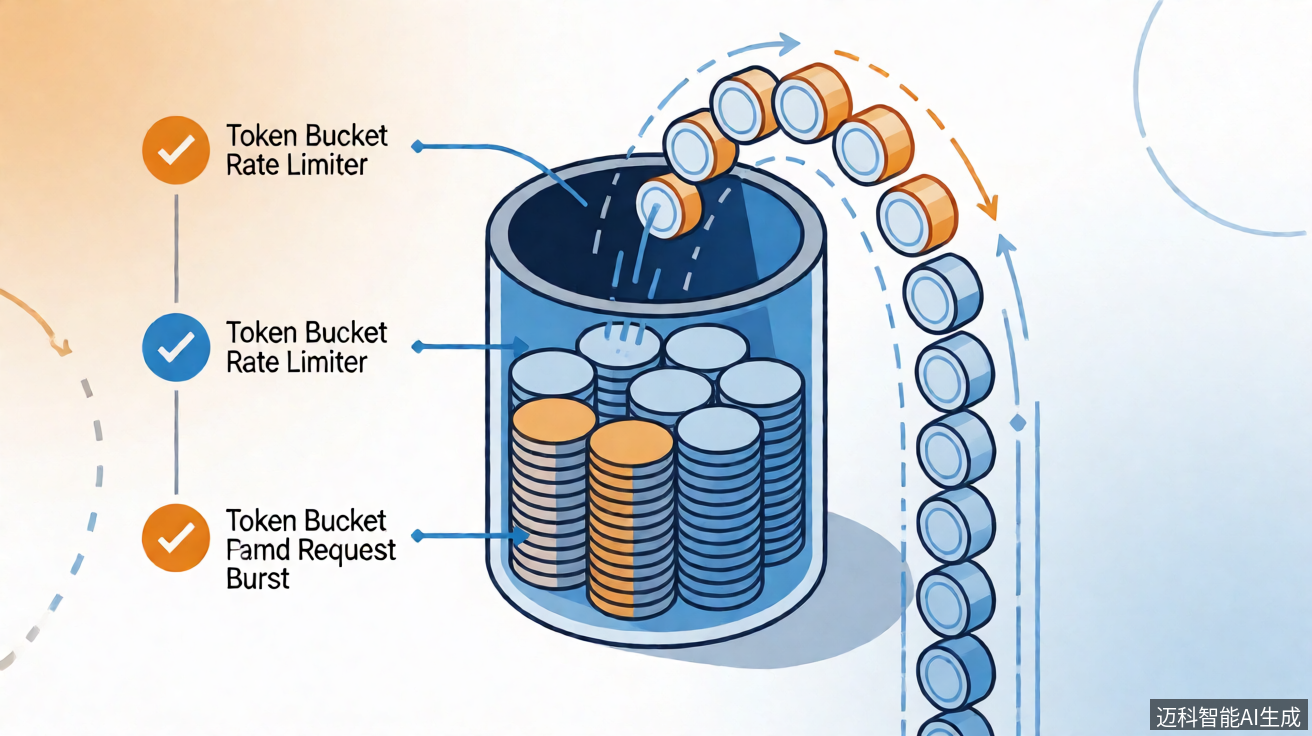
在确认根因后,修复的核心是把「无序并发」改为「受限、可重试、可熔断」。下面是一段带有令牌桶限流参数与重试机制的 Python 预热脚本,可作为紧急止血方案:
import time, threading, sys
from queue import Queue

class TokenBucket:
    def __init__(self, rate, capacity):
        self.rate = rate          # 每秒可发放令牌数(回源速率上限)
        self.capacity = capacity  # 桶容量(允许的瞬时突发)
        self.tokens = capacity
        self.last = time.monotonic()
        self.lock = threading.Lock()
    def acquire(self, n=1):
        while True:
            with self.lock:
                now = time.monotonic()
                self.tokens = min(self.capacity, self.tokens + (now - self.last)  self.rate)
                self.last = now
                if self.tokens >= n:
                    self.tokens -= n
                    return True
            time.sleep(0.05)

def preheat(url, retries=3):
    for i in range(retries):
        # 在此处调用CDN预热/回源接口,返回是否成功
        ok = call_preheat_api(url)
        if ok:
            return True
        time.sleep(2 * i)  # 指数退避重试,避免瞬时重试风暴
    return False

bucket = TokenBucket(rate=5, capacity=10)  # 速率5请求/秒,突发上限10
urls = read_resource_manifest()  # 资源清单
for u in urls:
    bucket.acquire()
    preheat(u)
    if circuit_breaker_open():
        sys.exit("熔断:源站异常率过高,暂停预热")
关键参数:令牌桶速率 rate=5(回源速率上限5请求/秒),容量 capacity=10 允许少量突发;指数退避重试避免失败请求反复重放;并引入 circuit_breaker_open() 判断源站5xx错误率,一旦越限即整体停止,防止雪崩。
最佳实践
紧急止血之后,团队将预热策略升级为基于令牌桶算法的渐进式预热:按地域与资源热度分片,每个分片独立持有速率受限的令牌桶,错峰释放;边缘侧拉取速率始终低于源站安全阈值,源站看到的回源曲线是平滑而非尖刺。这种做法既保留了「提前铺缓存」的收益,又把源站暴露在风险内的窗口压到最低。令牌桶的优势在于既约束平均速率又容忍合理突发,相比固定间隔的脚本更贴合真实业务节奏,是保护源站稳定性的核心手段。
架构反思
比限流更值得反思的,是自动化运维脚本缺少熔断与人工确认。一条无人值守的批量命令,可以在几秒内把流量模型彻底改写,却没有任何环节停下来核对「这是否安全」。成熟的架构应内置熔断机制:源站错误率、回源带宽、延迟一旦越过阈值,脚本自动降速或中止;并保留人工确认环节,在大批量预热或刷新前强制走审批,把「高危操作」从自动化流水线上摘出来。熔断不是性能负担,而是把事故半径从「全站瘫痪」压缩到「局部降速」的关键护栏。
总结观点
这次事故给出的教训很简单,也很沉重:开发者在追求效率时,必须把系统韧性放在与功能同等的位置上。CDN预热本是为了更快、更稳地分发内容,但当自动化脚本把效率推过头、缺乏限流与熔断时,效率反而成了击垮源站的锤子。把令牌桶限流、指数退避、熔断和人工确认写成不可绕过的工程纪律,才是避免下一次「一条命令瘫痪全站」的真正答案。